Recommandation de contenus : Small Models locaux vs LLM globaux dans les Médias
Dans l’industrie des médias, la recommandation de contenus est le nerf de la guerre de l’attention. Jusqu’à présent, le choix semblait binaire : s’appuyer sur des algorithmes statistiques classiques, souvent limités en compréhension contextuelle, ou solliciter des LLM globaux, puissants mais coûteux et lents. L’émergence des Small Language Models (SLM) locaux marque une rupture stratégique majeure, offrant une alternative agile et souveraine pour personnaliser l’expérience utilisateur sans sacrifier la performance.
La problématique est cruciale pour les éditeurs : comment offrir une pertinence sémantique maximale tout en maîtrisant les coûts d’infrastructure et la latence ? Si les LLM globaux (comme GPT-4 ou Claude) excellent dans la compréhension de nuances complexes, l’utilisation de modèles locaux plus compacts permet une réactivité en temps réel indispensable pour le fil d’actualité ou la vidéo à la demande. Ce choix n’est plus seulement technique, il devient un enjeu de souveraineté des données.
Cette décision impacte directement le pilotage de la performance et l’expérience client. En choisissant entre le cloud et le local, les médias arbitrent entre puissance brute et contrôle total. Dans cet article, nous comparerons ces deux approches pour identifier comment optimiser la découvrabilité des contenus tout en garantissant un ROI pérenne.
LLM Globaux : La Rolls-Royce de la compréhension sémantique
Les LLM globaux sont inégalés pour analyser des métadonnées complexes et créer des ponts sémantiques entre des thématiques éloignées. Leur capacité d’inférence contextuelle permet de suggérer un article de fond à partir d’une simple brève, enrichissant considérablement le parcours utilisateur. Cependant, cette puissance a un prix : une latence élevée qui peut dégrader l’expérience de navigation et des coûts d’API qui explosent dès que l’audience se compte en millions.
[Tableau : Coûts d’inférence vs Latence pour LLM Globaux]
De plus, confier ses données de consommation à des modèles tiers pose la question de la dépendance. La gouvernance et l’éthique de l’IA imposent une vigilance accrue sur la manière dont les préférences des utilisateurs sont exploitées par ces géants technologiques. Pour un média, perdre la maîtrise de ses « First-party data » est un risque stratégique majeur.
Small Models Locaux : L’agilité au service de la personnalisation
Les Small Language Models (SLM), tels que Mistral 7B ou Phi-3, offrent une performance « Good Enough » largement suffisante pour la recommandation de contenus. Leur principal atout est la latence réduite : l’inférence se fait localement ou sur des serveurs dédiés, garantissant une réponse quasi instantanée. L’intégration de ces modèles dans une stack data moderne permet de personnaliser l’interface utilisateur sans délai perceptible.
Le fine-tuning est l’autre avantage majeur des modèles locaux. Un média peut entraîner un SLM sur sa propre ligne éditoriale et son historique d’archives pour qu’il comprenne les spécificités de son catalogue. L’analyse de patterns spécifiques à l’audience du média devient alors bien plus précise qu’avec un modèle généraliste, car l’IA « parle » la langue du média et de ses lecteurs.
Souveraineté et Privacy : Le match décisif
Le choix du local est avant tout un choix de souveraineté. Garder les algorithmes de recommandation « on-premise » ou sur un cloud privé garantit que les données de comportement ne sortent jamais du périmètre de l’entreprise. La protection des données et la personnalisation des parcours deviennent alors compatibles avec les exigences RGPD les plus strictes.
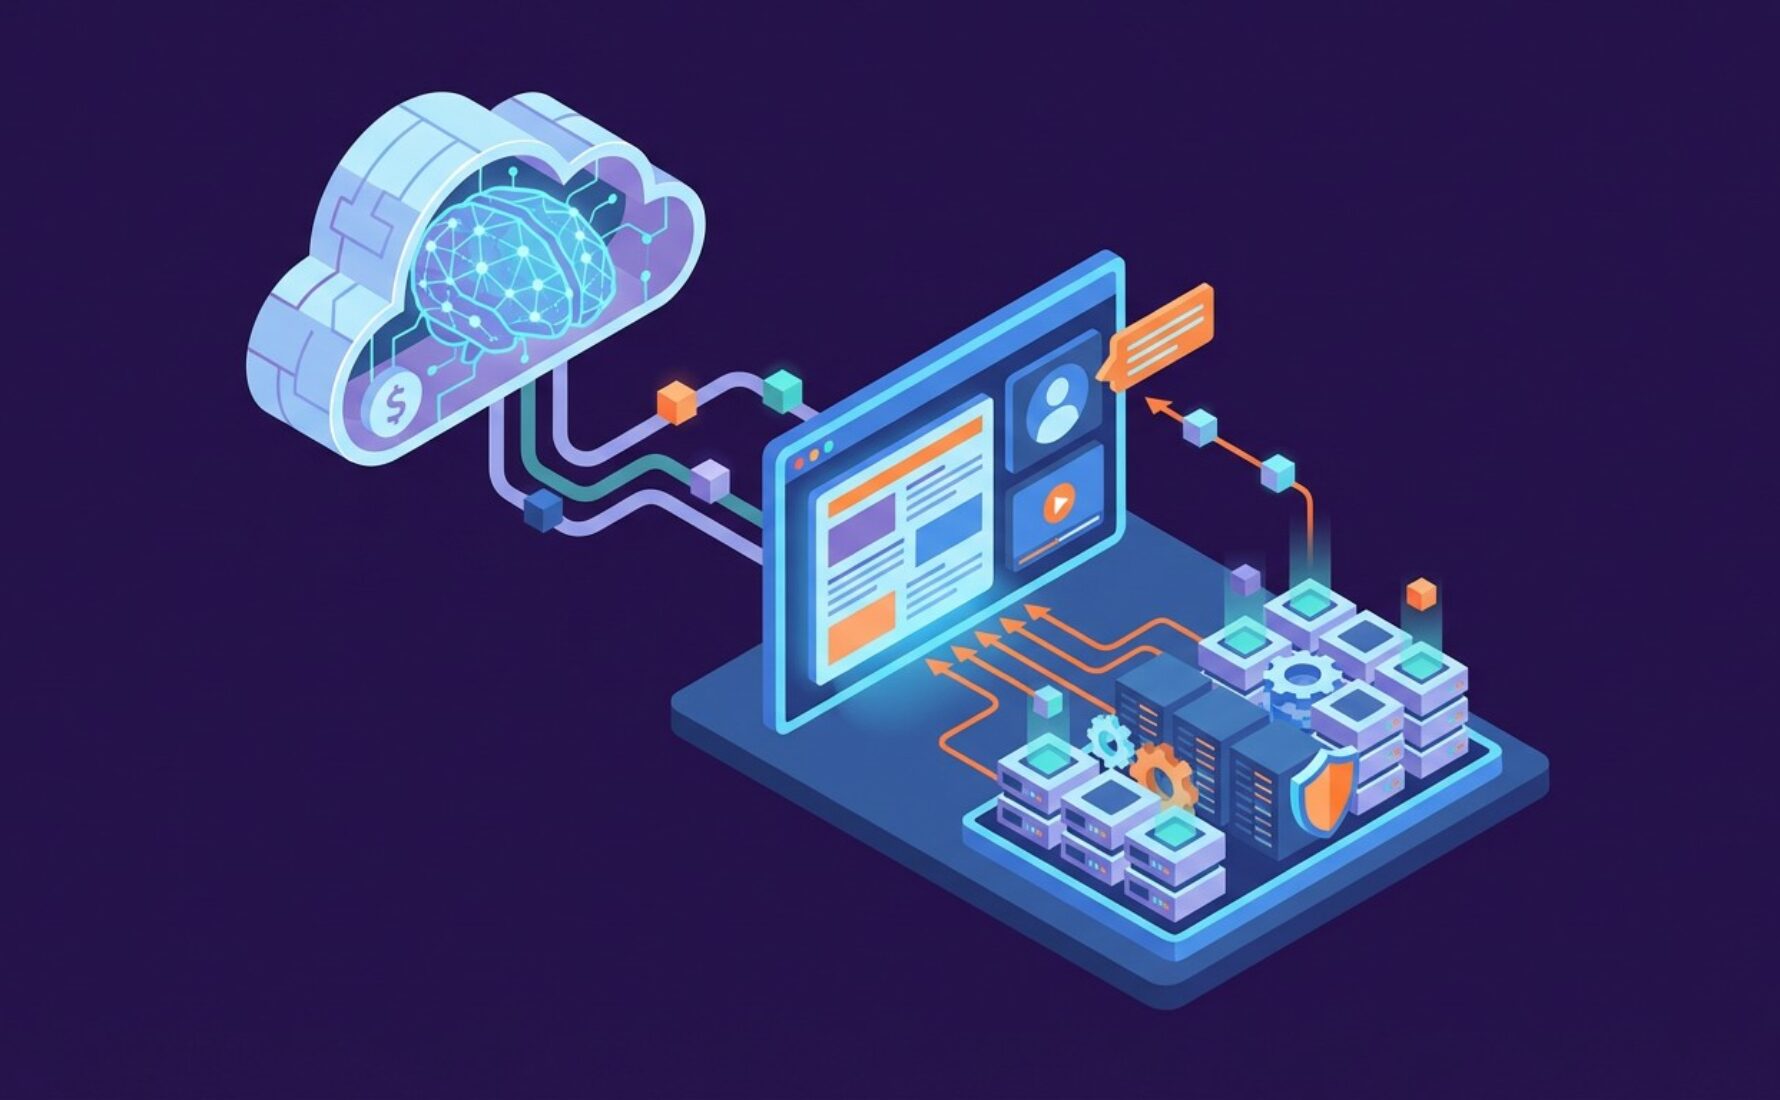
L’IA hybride émerge comme le compromis gagnant. Dans cette architecture, un Small Model gère 95% des recommandations quotidiennes pour son efficacité, tandis qu’un LLM global est sollicité pour des tâches complexes de synthèse ou de génération de métadonnées froides. Cette approche permet de bénéficier du meilleur des deux mondes : la souveraineté et la rapidité du local, couplées à l’intelligence profonde des grands modèles.