Historisation des données tarifaires : Comment préparer les datasets pour vos modèles IA en Assurance ?
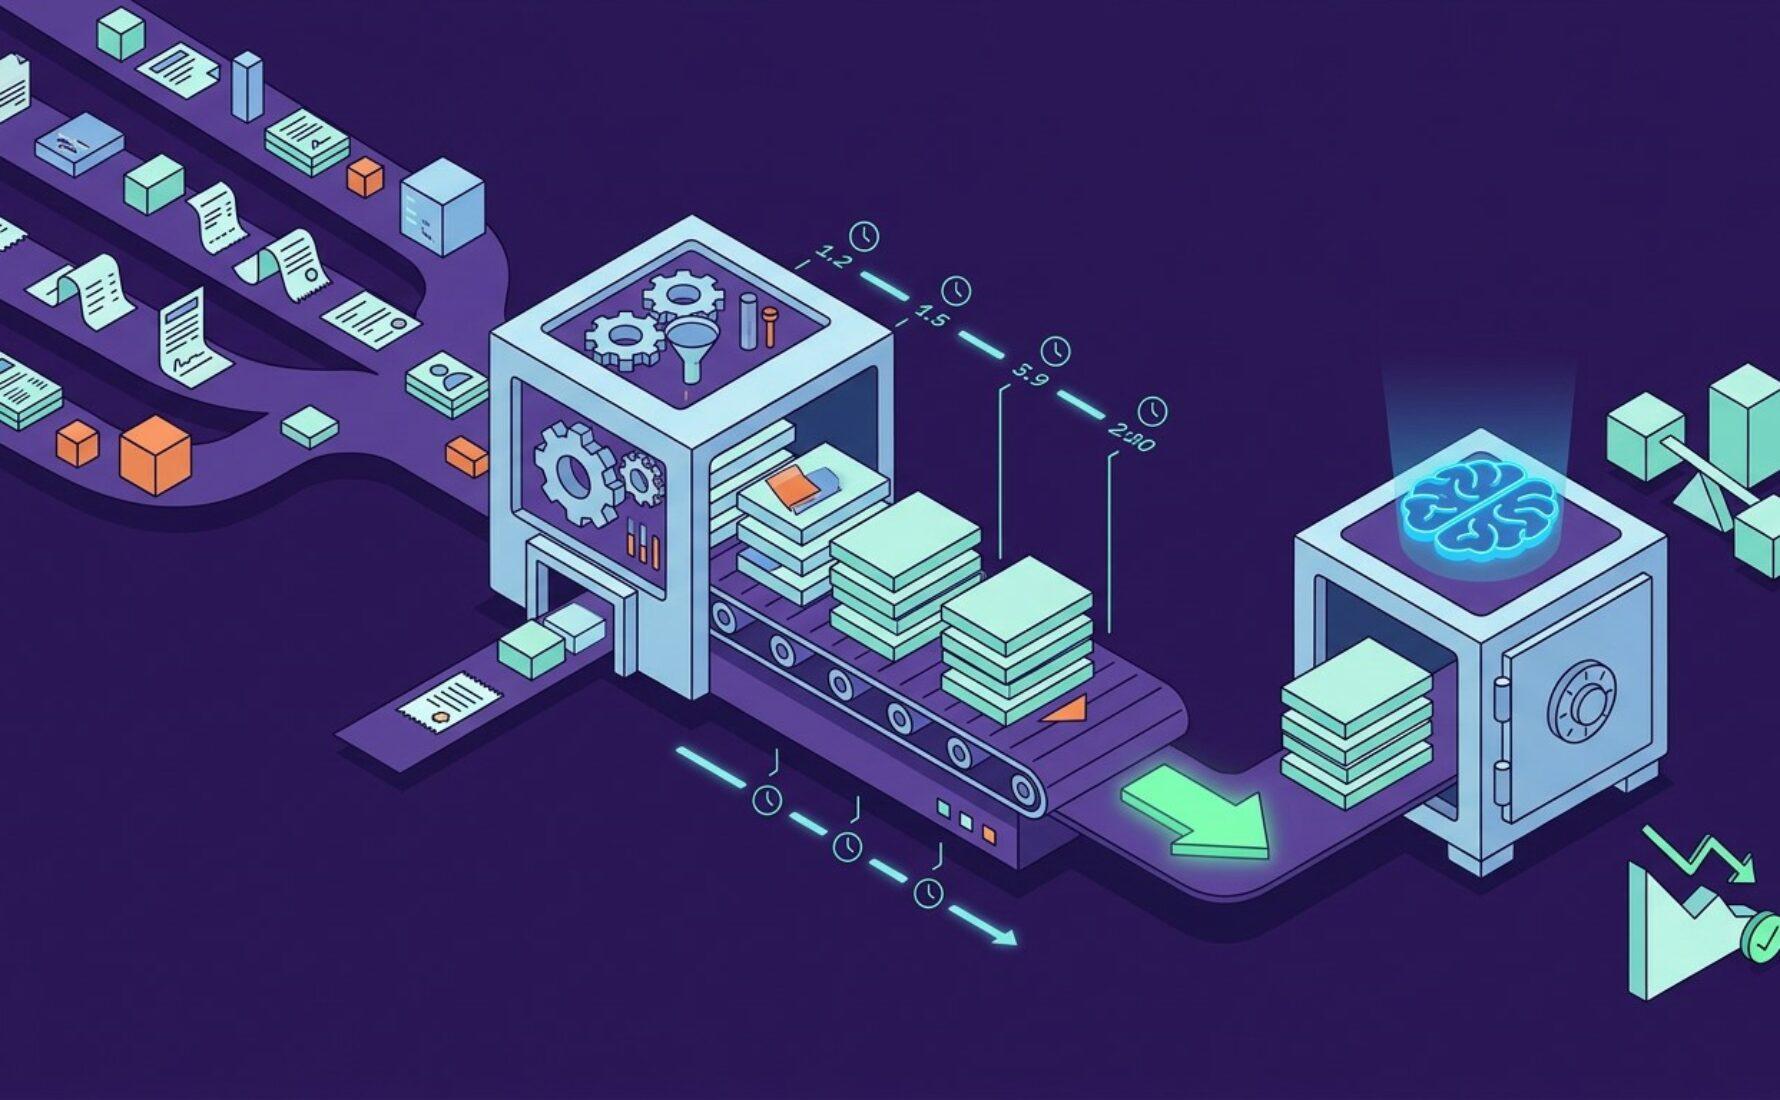
Table des matières
- Le socle technique : Structurer l’historisation pour l’IA
- La préparation des datasets : Du Feature Engineering à la validation
- Cas d’usage : Optimisation de la tarification et scoring de risque
- Vers une stratégie Data durable en Assurance
L’avènement de l’intelligence artificielle générative et prédictive transforme radicalement les directions techniques et actuarielles des compagnies d’assurance. Dans ce contexte de mutation profonde, la donnée ne se contente plus d’être un simple enregistrement comptable ou administratif mais devient le carburant essentiel des algorithmes de tarification. La capacité d’un assureur à transformer son stock d’informations brutes en datasets structurés et historisés permet de déterminer aujourd’hui son avantage concurrentiel sur un marché de plus en plus volatil.
Le passage d’une gestion de données transactionnelle à une approche orientée « Data-Centric AI » représente un défi majeur pour les acteurs traditionnels de l’assurance. Si la plupart des organisations disposent de volumes massifs d’informations, la difficulté réside souvent dans la qualité et la continuité temporelle de ces actifs. Une historisation défaillante ou fragmentée limite considérablement la précision des modèles, empêchant la capture fine des cycles de sinistralité et des évolutions de comportement des assurés sur le long terme.
Il est désormais établi que la performance d’un modèle d’apprentissage automatique dépend davantage de la qualité des données d’entraînement que de la complexité de l’algorithme choisi. Pour les experts de la data en assurance, l’enjeu consiste à reconstruire des parcours de vie de contrats et de sinistres sans aucune rupture de séquence. Cette rigueur méthodologique permet de passer d’une vision statique du risque à une analyse dynamique capable d’anticiper les tendances futures avec une marge d’erreur réduite.
Cet article explore les leviers stratégiques pour structurer l’historisation de vos données tarifaires et préparer des datasets robustes pour vos modèles IA. Nous aborderons les fondements techniques de la structuration temporelle, les meilleures pratiques de feature engineering appliqué au secteur de l’assurance, ainsi que les cas d’usage concrets permettant d’optimiser la prime technique. L’objectif est de fournir une feuille de route claire pour transformer votre héritage de données en un levier de performance durable et actionnable.
Le socle technique : Structurer l’historisation pour l’IA
La mise en place d’une architecture de données robuste est le préalable indispensable à tout projet d’intelligence artificielle. En assurance, cela implique de passer d’une vision « snapshot » (photographie à l’instant T) à une vision « log-based » permettant de reconstituer chaque modification d’un contrat ou d’un profil client. Pour nourrir efficacement un modèle IA, il ne suffit pas de savoir qu’un client possède tel contrat aujourd’hui, il faut comprendre quand et pourquoi ses garanties ont évolué. Les entreprises qui parviennent à intégrer cette dimension temporelle constatent une amélioration de la précision de leurs prédictions de sinistralité pouvant atteindre 20 %. Cette précision accrue se traduit directement par une meilleure segmentation des risques et une réduction de l’antisélection.
Le choix de l’infrastructure de stockage joue un rôle pivot dans cette stratégie d’historisation. Tandis que le Data Warehouse traditionnel excelle pour le reporting réglementaire et l’actuariat classique, le Data Lake offre la flexibilité nécessaire à l’exploration de données non structurées, comme les rapports d’expertise ou les interactions avec le service client. Pour une historisation optimale, l’adoption d’une architecture hybride ou d’un Data Lakehouse permet de maintenir des versions historiques immuables de chaque dataset, ce qui garantit que les data scientists peuvent réentraîner des modèles sur des données passées sans risque de pollution par des mises à jour ultérieures, respectant ainsi le principe de reproductibilité indispensable en environnement de production IA.
La préparation des datasets : Du Feature Engineering à la validation
Une fois l’infrastructure en place, l’étape du feature engineering consiste à transformer les données brutes en variables explicatives pertinentes pour les modèles de tarification. En assurance, cette phase est particulièrement critique car elle doit intégrer la saisonnalité et les délais de liquidation des sinistres. Par exemple, au lieu d’utiliser simplement l’âge de l’assuré, un modèle performant s’appuiera sur des variables dérivées comme l’ancienneté du permis au moment de la souscription comparée à l’historique de sinistralité sur les dix dernières années. Créer ces variables temporelles demande une historisation sans faille pour éviter le biais de look-ahead, où le modèle utiliserait par erreur des informations futures pour prédire un événement passé lors de la phase d’entraînement.
La gestion de la qualité des données et des biais historiques constitue le second pilier de la préparation des datasets. Les données de l’assurance sont naturellement entachées de biais liés aux anciennes stratégies commerciales ou à des évolutions réglementaires passées. Un expert en data science doit être capable d’identifier ces anomalies pour éviter que l’IA ne reproduise des schémas de tarification obsolètes ou injustes. Le nettoyage des données manquantes, souvent nombreuses dans les vieux portefeuilles, ne doit pas se faire par simple suppression mais par des techniques d’imputation sophistiquées ou par l’utilisation de métadonnées de contexte. Comme le soulignent souvent les experts en gouvernance, une donnée historisée mais non contextualisée perd 80 % de sa valeur prédictive pour un modèle d’intelligence artificielle.
Cas d’usage : Optimisation de la tarification et scoring de risque
L’application concrète de ces datasets historisés trouve son apogée dans l’optimisation de la prime technique. En disposant d’un historique long et granulaire, les assureurs peuvent entraîner des modèles de gradient boosting ou des réseaux de neurones capables de détecter des micro-segments de risques jusqu’alors invisibles. Par exemple, l’analyse croisée des historiques de paiement, des interactions digitales et de la sinistralité permet d’ajuster les tarifs en temps réel selon le profil de risque réel plutôt que selon des moyennes statistiques larges. Cette approche permet non seulement de protéger les marges techniques mais aussi de proposer des tarifs plus compétitifs aux profils les moins risqués, favorisant ainsi la rétention des bons clients.
Un autre cas d’usage majeur réside dans le scoring de l’attrition, ou churn. Grâce à une historisation fine des signaux faibles, comme une consultation répétée des conditions de résiliation sur l’espace client ou une baisse de la fréquence des contacts, les modèles d’IA peuvent prédire la probabilité de départ d’un assuré avec plusieurs mois d’avance. En couplant cette prédiction à une analyse de la valeur vie client (LTV), les directions marketing peuvent déclencher des actions de rétention ultra-ciblées. Chez Converteo, nous avons observé que l’intégration de données comportementales historisées dans les modèles de churn permet de multiplier par deux l’efficacité des campagnes de fidélisation, transformant la donnée historique en un véritable centre de profit.
Vers une stratégie Data durable en Assurance
La réussite de vos projets d’intelligence artificielle en assurance ne dépend pas de la puissance de calcul de vos serveurs, mais de la profondeur et de la clarté de votre mémoire organisationnelle. L’historisation des données tarifaires est un investissement de long terme qui demande une collaboration étroite entre les actuaires, les data engineers et les directions métier. En structurant vos datasets avec une rigueur temporelle, vous ne vous contentez pas d’améliorer vos modèles actuels, vous préparez votre infrastructure à accueillir les innovations technologiques de demain. Une donnée bien conservée et intelligemment préparée est le socle sur lequel se bâtit l’assurance de demain, plus juste, plus précise et plus agile.
Pour transformer cet essai, il est essentiel de débuter par un audit complet de votre patrimoine data et de votre stack technologique. L’objectif est d’identifier les zones de rupture dans vos historiques et de mettre en place des pipelines d’ingestion capables de nourrir vos futurs modèles en continu. Les experts de Converteo vous accompagnent dans cette structuration, de la définition de la stratégie d’historisation jusqu’au déploiement opérationnel de vos modèles IA. Ne laissez pas votre héritage de données dormir dans des silos ; faites-en le moteur de votre excellence tarifaire et de votre croissance future.